Dépliant — Enquête canadienne sur le logement

Les renseignements sur le logement jouent un rôle clé pour surmonter les défis liés au logement

Un logement est plus qu'un toit sur nos têtes

Connaître les besoins et les expériences en matière de logement des Canadiens et Canadiennes nous permet de comprendre les défis liés au logement à l'échelle du pays. Pour y parvenir, Statistique Canada a besoin de vous!

L'Enquête canadienne sur le logement (ECL) de 2026 permet de recueillir des renseignements précieux sur les besoins et les expériences en matière de logement.

Vos réponses aideront à comprendre et à aborder des enjeux comme l'accès au logement abordable, ainsi qu'à améliorer les conditions de logement. Les renseignements que vous fournissez demeureront strictement confidentiels.

Statistique Canada mène l'ECL en partenariat avec la Société canadienne d'hypothèques et de logement.

L'enquête contribuera à répondre à des questions comme les suivantes :

  • Quels défis les Canadiens et Canadiennes rencontrent-ils en matière d'abordabilité du logement?
  • Quelles parties de la population ont vécu des situations telles que l'itinérance et des expulsions?
  • Dans quel genre de maisons et de quartiers les Canadiens et Canadiennes souhaitent-ils vivre?
  • De quelle façon les résultats en matière de logement diffèrent-ils entre les groupes sociodémographiques?

La personne qui est responsable de prendre des décisions en matière de logement au sein de votre ménage devrait répondre à l'ECL de 2026. Si vous êtes locataire et vivez à la même adresse que le propriétaire, le propriétaire devrait répondre à l'enquête.

Votre participation peut avoir une grande incidence

Des personnes qui résident dans les 10 provinces sont invitées à répondre à cette enquête. Votre participation aidera Statistique Canada à brosser un tableau à jour des besoins en matière de logement des Canadiens et Canadiennes et de la situation liée à l'abordabilité du logement à l'échelle du pays.

Les renseignements recueillis serviront à éclairer la prise de décisions relatives aux programmes sociaux et de logements visant à répondre aux besoins des Canadiens et Canadiennes.

Vos réponses sont importantes puisqu'elles représentent non seulement votre point de vue, mais aussi celui d'autres Canadiens et Canadiennes comme vous. Chaque réponse permet d'améliorer la qualité des résultats.

Votre participation compte, quelle que soit votre situation en matière de logement.

C'est facile de participer

Veuillez vous reporter à la lettre que vous avez reçue de Statistique Canada. Elle comporte les renseignements dont vous avez besoin pour accéder à l'enquête et y répondre.

Nous savons que les Canadiens et les Canadiennes sont occupés, et nous vous sommes énormément reconnaissants de prendre le temps de nous aider dans le cadre de l'ECL.

Les renseignements que vous fournissez sont confidentiels

Tous les renseignements recueillis par Statistique Canada demeurent strictement confidentiels et sont protégés par la Loi sur la statistique. Statistique Canada ne peut divulguer aucun renseignement qui permettrait de vous identifier, vous ou un membre de votre ménage, sans votre consentement. Aucune autre loi, ni même la Loi sur l'accès à l'information, n'autorise la divulgation de ces renseignements.

Vous voulez en savoir plus?

Visitez www.statcan.gc.ca/ECL

Pour les demandes liées à l'enquête :
1-833-977-8287

Pour obtenir de l'aide technique ou d'autres renseignements :
1-877-949-9492

ATS (appareil de télécommunications pour personnes sourdes) :
1-866-753-7083

Merci de votre participation!

Suivez-nous sur les réseaux sociaux

Évaluation des facteurs relatifs à la vie privée concernant le Programme de suivi de la présence sur les lieux de travail et de production de rapports sur la conformité

Titre

Programme de suivi de la présence sur les lieux de travail et de production de rapports sur la conformité

Description

Statistique Canada utilisera des renseignements personnels provenant des données des tourniquets et des données administratives des Ressources humaines pour produire des rapports visant à surveiller la conformité à l'Orientation concernant la présence prescrite au lieu de travail du Conseil du Trésor (l'Orientation) et soutenir les cadres dans la gestion de la conformité à l'Orientation.

Pourquoi une évaluation des facteurs relatifs à la vie privée a été réalisée

La production et la diffusion du rapport sur la présence sur les lieux de travail figurent dans le supplément à l'évaluation des facteurs relatifs à la vie privée (EFVP) du Système de contrôle d'accès automatisé, rédigé par Statistique Canada en juillet 2022.

Depuis la finalisation du supplément, deux autres rapports qui utilisent des renseignements personnels provenant des données des tourniquets ont été ajoutés au programme. L'un des rapports portera sur le suivi de la conformité individuelle des employés à l'Orientation. Ces changements apportés au programme constituent des modifications importantes au processus, qui comporte maintenant un volet administratif lié aux ressources humaines. L'EFVP a été réalisée pour tenir compte de ces modifications importantes, et la création d'un fichier de renseignements personnels (FRP) propre à l'institution est requise pour ce programme.

Renseignements supplémentaires

L'EFVP a permis d'identifier quatre risques pour la protection de la vie privée, lesquels ont été jugés faibles compte tenu des facteurs d'atténuation en place.

Fichiers de renseignements personnels connexes

Les FRP suivants se rapportent au programme : POE 901, POE 903 et POU 907. Un FRP propre à l'institution sera également enregistré pour rendre compte de l'utilisation de renseignements personnels afin de surveiller la conformité individuelle des employés à l'Orientation, dans le cadre d'un processus décisionnel.

Pour obtenir de plus amples renseignements sur cette évaluation des facteurs relatifs à la vie privée

Veuillez communiquer avec :

Pierre Desrochers
Dirigeant principal de la protection des renseignements personnels
Bureau de gestion de la protection de la vie privée et de coordination de l'information
Statistique Canada
Courriel : atip-aiprp@statcan.gc.ca

Série de webinaires sur les données de santé - Séance #5 : Aperçu de l'Enquête sur la santé dans les collectivités canadiennes

Le Programme de la statistique sur la santé de Statistique Canada est heureux de continuer la série de webinaires conçue pour les utilisateurs de données sur la santé. Ces séances d'une heure, offertes tous les deux ou trois mois, seront adaptées à vos besoins et à vos intérêts selon vos commentaires.

Détails du webinaire

Date : 28 octobre 2026
Séance en français : 11 h (HAE)
Séance en anglais : 13 h (HAE)

Inscription

Remplissez le formulaire d'inscription pour réserver votre place.

Ce que vous apprendrez

  • La présentation de l'Aperçu de l'Enquête sur la santé dans les collectivités canadiennes (ESCC) mettra l'accent sur les points suivants :
    • les indicateurs de santé de la population couverts par l'enquête
    • la portée de l'enquête et les populations pouvant être analysées à partir des données
    • la façon dont les données de l'ESCC peuvent être couplées à des données administratives sur la santé
  • Découvrez également où trouver les données les plus récentes et comment les adapter à vos besoins.

Présentateurs

  • Shawn Brule, Chef d'unite, Centre des données sur la santé des populations
  • Sarah Wickert, Analyste, Centre des données sur la santé des populations

À qui s'adresse ce webinaire?

Chercheurs, analystes, décideurs politiques et professionnels de la santé qui souhaitent tirer parti des données de santé de Statistique Canada pour mener des recherches et prendre des décisions éclairées.

Contactez-nous

Pour toute question, communiquez avec statcan.hspoutreach-sensibilisationpss.statcan@statcan.gc.ca

Modélisation des stocks de fermeture de mars et de juillet à l'aide des données d’enquête et des données administratives

1. Introduction

Le présent rapport fournit le contexte, les méthodes générales et les résultats du modèle utilisé pour produire les estimations des stocks des principales grandes cultures en mars et en juillet. Le travail a été réalisé par la Division de l'agriculture et la Division des méthodes de la statistique économique à Statistique Canada.

La méthodologie générale du modèle, qui énumère les combinaisons ciblées culture-province, est décrite à la section 2. La section 3 contient les sources de données utilisées pour créer l'ensemble de prédicteurs. La section 4 présente les méthodes de modélisation et les mesures d'évaluation utilisées, et la section 5 donne les résultats.

2. Méthodologie générale de modélisation des stocks de fermeture

Une méthodologie de modélisation des stocks à la ferme des principales grandes cultures a été élaborée et mise à l'essai sur les combinaisons culture-province qui sont habituellement publiées à partir de la Série de rapports sur les grandes cultures, comme le montre le tableau 1. Ces combinaisons culture-province représentent presque la totalité des grandes cultures entreposées dans les fermes canadiennes.

Tableau 1. Stocks à la ferme des principales grandes cultures, habituellement publiés dans les résultats des enquêtes agricoles de mars et de juillet, par province

Type de culture

Province

Québec

Ontario

Manitoba

Saskatchewan

Alberta

Orge

Oui

Oui

Oui

Oui

Oui

Canola

Oui

Oui

Oui

Oui

Oui

Maïs-grain

Oui

Oui

Oui

Non

Oui

Avoine

Oui

Oui

Oui

Oui

Oui

Seigle

Oui

Oui

Oui

Oui

Oui

Pois secs

Non

Non

Oui

Oui

Oui

Graines de lin

Non

Non

Oui

Oui

Oui

Lentilles

Non

Non

Oui

Oui

Oui

Soya

Oui

Oui

Oui

Oui

Non

Blé dur

Non

Non

Non

Oui

Oui

Blé total, excluant blé dur

Oui

Oui

Oui

Oui

Oui

Graines de l'alpiste des CanariesNote de bas de page 1

Non

Non

Non

Non

Non

Pois chichesNote de bas de page 1

Non

Non

Non

Non

Non

Graines de moutardeNote de bas de page 1

Non

Non

Non

Non

Non

Graines de tournesolNote de bas de page 1

Non

Non

Non

Non

Non

Note de bas de page 1

disponible uniquement au niveau national

Retour à la première référence de la note de bas de page1

Note : Les stocks à la ferme ont été modélisés dans les Maritimes et/ou en Colombie-Britannique pour certaines cultures (avoine, canola, soja, maïs, orge, pois secs et blé) lorsque les données étaient disponibles.

L'objectif du modèle est de produire des estimations officielles et exactes des stocks de fermeture à la ferme en mars et en juillet pour certaines combinaisons culture-province au moyen de l'information provenant de sources de données existantes. La qualité des estimations du modèle sera examinée plus en détail dans la sous-section 4.3 et la section 6.

3. Sources de données utilisées dans le modèle

La méthodologie de modélisation a utilisé trois sources de données : 1) données de la Série de rapports sur les grandes cultures de Statistique Canada; 2) données de l'Indice des prix des produits agricoles de Statistique Canada; 3) données de la Commission canadienne des grains (CCG).

3.1 Données de la Série de rapports sur les grandes cultures

La Série de rapports sur les grandes cultures de Statistique Canada obtient de l'information sur l'industrie céréalière canadienne (pour obtenir des détails sur la méthodologie de la Série de rapports sur les grandes cultures, veuillez consulter la page Web de la Série de rapports sur les grandes cultures). Les enquêtes visant à recenser les stocks à la ferme ont traditionnellement été menées chaque année en mars (annulées en 2023), en juillet (en juin depuis 2020), en septembre (annulées en 2016), en novembre et en décembre. À mesure que la campagne agricole avance, différents aspects de l'industrie céréalière sont recueillis. Certaines de ces mesures ont été utilisées directement (comme les intentions d'ensemencement, les stocks de fermeture à la ferme, la production des grandes cultures), et d'autres ont servi à calculer de nouveaux prédicteurs (comme le pourcentage de ressources qui ont été produites et le pourcentage des utilisations qui ont été livrées).

3.2 Données de l'Indice des prix des produits agricoles

L'Indice des prix des produits agricoles diffuse des estimations du prix de divers produits agricoles, y compris presque toutes les céréales et les grandes cultures pour lesquelles les stocks de fermeture sont publiés. Les prix sont publiés mensuellement pour chaque province. Comme cette analyse porte sur une période de plus de 15 ans, l'inflation occulterait la relation entre le prix et les stocks de fermeture. C'est pourquoi le prix sous sa forme brute n'était pas un prédicteur convenable. Les prix provinciaux mensuels bruts pour chaque grain et chaque grande culture ont été transformés en deux prédicteurs (différence en pourcentage d'une année à l'autre et différence en pourcentage d'un trimestre à l'autre) qui convenaient mieux au modèle.

3.3 Autres données de la Commission canadienne des grains

La Commission canadienne des grains (CCG) recueille des données sur de nombreux aspects de l'industrie céréalière au Canada. Elle recueille notamment les livraisons de grandes cultures des fermes aux silos. Les livraisons sont diffusées chaque semaine dans le cadre du programme Statistiques hebdomadaires des grains de la CCG à l'échelle provinciale.

Compte tenu de la fréquence de publication des données de la CCG, cinq prédicteurs ont été établis : le nombre total de livraisons et le volume total des livraisons d'aliments pour animaux au cours des périodes d'enquête de la Série de rapports sur les grandes cultures de décembre à mars et de mars à juillet, ainsi que le volume cumulatif des livraisons d'aliments pour animaux depuis le début de la campagne agricole.

3.4 Bassin de prédicteurs plus vaste en juillet qu'en mars

Comme les données d'entrée du modèle de juillet présentent une plus grande variabilité que celles de mars, le modèle de juillet nécessite des prédicteurs supplémentaires pour atteindre une forte capacité prédictive. Les vérifications ont confirmé que ces prédicteurs supplémentaires n'amélioraient pas le rendement du modèle de mars; ils ont donc été exclus du modèle de mars afin d'éviter toute complexité inutile. On a constaté que ces différents bassins de prédicteurs donnaient les meilleurs résultats pour chaque modèle.

Alors que le modèle de mars utilise le pourcentage des ressources restantes (stocks de fermeture et aliments pour animaux, déchets et impuretés) qui correspondaient aux stocks de fermeture lors de la période d'enquête précédente, le modèle de juillet utilise cette valeur pour les trois périodes d'enquête précédentes.

Les modèles diffèrent également au chapitre de leurs prédicteurs relatifs à la livraison des aliments pour animaux. Les deux modèles tiennent compte du volume total des livraisons d'aliments pour animaux depuis la période d'enquête précédente. Le modèle de juillet va plus loin en intégrant la proportion de livraisons correspondant à des livraisons d'aliments pour animaux au cours de cette même période, ainsi que deux prédicteurs décalés : le total des livraisons d'aliments pour animaux et la proportion de livraisons correspondant à des livraisons d'aliments pour animaux lors des deux périodes d'enquête précédentes. En revanche, le modèle de mars tient compte du total des livraisons d'aliments pour animaux et de la proportion de ces livraisons par rapport à l'ensemble des livraisons effectuées depuis le début de la campagne agricole.

4. Modélisation des stocks de fermeture de mars et de juillet

4.1 Méthodes de modélisation

Le modèle est construit à partir des relations historiques entre l'estimation publiée des stocks de céréales à la ferme et les diverses caractéristiques des cultures et des industries céréalières. Les données à partir de 2006 sont utilisées pour l'élaboration du modèle.

Les stocks de céréales à la ferme sont estimés à l'aide du langage de programmation statistique R. Deux algorithmes d'apprentissage sont utilisés : Elastic-Net, du paquet glmnet, pour la sélection des caractéristiques, et la régression robuste, du paquet MASS, pour la prédiction.

La procédure Elastic-Net a permis de sélectionner les paramètres optimaux du modèle à l'aide d'une validation croisée par exclusion d'un élément, afin de trouver un juste équilibre entre l'ajustement du modèle et le rendement prédictif. Les prédicteurs qui n'ont pas été rétrécis à zéro au moyen d'Elastic-Net sont traités par la régression robuste. La régression robuste utilise l'estimateur MM.

4.2 Définition de la cible

L'estimation des stocks de céréales à la ferme la plus exacte est l'estimation publiée. Sur le plan historique, l'estimation publiée était calculée à partir de l'estimation de l'enquête de la Série de rapports sur les grandes cultures, qui était ajustée au moyen de l'équation des ressources et des utilisations ainsi que d'autres sources de données servant de référence. Ce processus est décrit plus amplement ici : Bilan des grains au Canada.

Le bilan est établi comme suit :

UTILISATION = LIVRAISONS + SEMENCES + STOCK DE FERMETURE + ALIMENTS POUR ANIMAUX, DÉCHETS, IMPURETÉS

et

APPROVISIONNEMENT = STOCK D'OUVERTURE + PRODUCTION

où

APPROVISIONNEMENT = UTILISATION

 Les estimations des  LIVRAISONS sont tirées des données administratives de la CCG.

Les estimations de  PRODUCTION proviennent de l'Enquête sur les grandes cultures de novembre pour les modèles de mars et de juillet.

Les  STOCKS D'OUVERTURE correspondent aux stocks de fermeture indiqués dans l'Enquête sur les grandes cultures de décembre et dans celle de mars, respectivement pour les modèles de mars et de juillet.

Les estimations des  STOCKS DE FERMETURE avaient été tirées à partir de l'Enquête sur les grandes cultures de mars et de celle de juillet, respectivement pour les modèles de mars et de juillet.

Les estimations de l'  UTILISATION DES SEMENCES sont tirées de l'Enquête sur les grandes cultures de novembre et de celle de mars, respectivement pour les modèles de mars et de juillet.

Les estimations des  ALIMENTS POUR ANIMAUX ,  DÉCHETS et  IMPURETÉS sont le résidu de l'équation donnée ci-dessus.

Quand vient le moment d'estimer les stocks de céréales à la ferme, les estimations de toutes les variables, sauf les aliments pour animaux, les déchets et les impuretés, sont disponibles. Par conséquent, l'équation peut être réécrite ainsi :

APPROVISIONNEMENT - LIVRAISONS - SEMENCES = STOCK DE FERMETURE + ALIMENTS POUR ANIMAUX, DÉCHETS, IMPURETÉS

ou

RESTANTS = STOCK DE FERMETURE + ALIMENTS POUR ANIMAUX, DÉCHETS, IMPURETÉS

Le modèle est finalement conçu pour remplacer les estimations des stocks à la fermeture dans les fermes de mars et de juillet. Cependant, étant donné que la quantité restante est connue, il sert à stabiliser la cible. La cible du modèle est le pourcentage de reste que représentent les stocks à la fermeture.

Comme l'estimation de l'enquête, l'estimation modélisée peut faire l'objet d'ajustements au moyen de l'équation de bilan et d'autres sources de données utilisées servant de référence.

4.3 Méthodes d'évaluation du modèle

Pendant la phase de recherche du projet, de nombreux paramètres de modèle ont été examinés. Ils comprenaient les algorithmes d'apprentissage utilisés aux fins de prédiction, la taille du groupe de prédicteurs et la forme de la cible.

On a évalué la réussite du modèle en mesurant l'exactitude et le biais des différents choix de paramètres. Pour y parvenir, on a comparé les prédictions avec les estimations publiées des stocks de fermeture à la ferme pour mars et juillet, tant au niveau des cultures qu'au niveau des provinces et des cultures. Dans les deux cas, l'erreur absolue moyenne pondérée en pourcentage (EAMPP) a été utilisée comme mesure de l'exactitude et l'erreur moyenne relative (EM) comme mesure du biais. L'évaluation de ces deux mesures permet de s'assurer que les prédictions sont non seulement proches des valeurs réelles en moyenne, mais aussi exemptes d'erreurs directionnelles systématiques susceptibles de fausser les estimations.

Voici la formule pour l'erreur absolue moyenne pondérée en pourcentage :

EAMPP = ∑ i = 1 n | publiée i - prédiction i | ∑ i = 1 n publiée i

Voici la formule pour l'erreur moyenne relative :

EM Relative = ∑ i = 1 n publiée i - prédiction i ∑ i = 1 n publiée i

où  prédiction est la prédiction du modèle,  publiée est l'estimation publiée,  i est une observation donnée et  n est le nombre total d'observations dans une culture ou un groupe province-culture.

5. Résultats

Dans l'ensemble, ce modèle se compare favorablement aux résultats des enquêtes de mars et de juillet.

Pour la période de mars, à l'exception de deux cultures, c'est-à-dire l'orge et le maïs, le modèle donne de meilleurs résultats que l'enquête. L'enquête ne surpasse que très légèrement le modèle en ce qui concerne l'orge et le maïs. Une analyse plus approfondie a été menée pour l'orge (les données sur les livraisons d'aliments pour animaux publiées par la CCG ont été examinées et des experts en la matière ont été consultés). Cependant, rien n'a permis d'expliquer de manière satisfaisante cet écart.

Pour la période de juillet, le modèle donne de meilleurs résultats que l'enquête pour toutes les cultures. Les améliorations sont encore plus marquées que celles observées pour la période de mars. La répartition des biais pour l'ensemble des cultures s'améliore considérablement en mars et en juillet, les valeurs devenant plus regroupées et centrées autour de zéro.

6. Indicateurs de la qualité des données

6.1 Intervalle de confiance (IC)

Tous les modèles prédictifs sont sujets à l'erreur. Il est par conséquent important de mesurer le degré d'incertitude dans les estimations des modèles. Cela est effectué au moyen de l'intervalle de confiance.

Voici un guide concis de l'estimation bootstrap de la variance pour le modèle des stocks à la fermeture de mars et de juillet. Le principal objectif de cette estimation est de saisir la variance de l'ensemble du processus de modélisation. Par conséquent, l'élément clé du bootstrap, soit l'échantillonnage avec remise, se produit au début du processus de modélisation.

Étape 1 : Échantillonnage aléatoire stratifié avec remise

L'ensemble de données d'entraînement, qui contient toutes les observations à partir desquelles le modèle original est construit, est stratifié par province, puis échantillonné au hasard avec remise au niveau de l'observation. S'il y avait 10 observations au départ, le nouvel ensemble bootstrap contiendra également 10 observations, mais il pourrait y avoir des récurrences de la même observation en raison de l'échantillonnage aléatoire stratifié avec remise.

Étape 2 : Régression Elastic-Net pour déterminer la taille de pénalité optimale

On effectue une validation croisée sur une régression Elastic-Net (à 4 blocs, en essayant 100 tailles de pénalité différentes) sur l'ensemble de modélisation bootstrap pour trouver la taille de pénalité optimale. Cette taille de pénalité optimale est ensuite utilisée à l'étape suivante.

Étape 3 : Régression Elastic-Net pour créer un bassin réduit de prédicteurs

Elastic-Net est réentraîné en utilisant la taille de pénalité optimale obtenue à l'étape 2. Le modèle optimal qui en résulte peut rétrécir certains coefficients de prédiction à zéro. Dans ce cas, les prédicteurs seraient retirés du groupe initial de prédicteurs, ce qui créerait un bassin réduit de prédicteurs.

Étape 4 : Entraîner une régression robuste avec le bassin réduit de prédicteurs

L'ensemble de modélisation bootstrap est limité au bassin réduit de prédicteurs, puis ajusté au moyen d'une régression robuste. Cette régression robuste est le modèle qui fournit l'estimation finale.

Étape 5 : Établir une prédiction au moyen du modèle de régression robuste entraîné

La régression robuste entraînée est appliquée à l'ensemble de prédiction.

Étape 6 : Répéter 1 000 fois les étapes 1 à 5

Les étapes 1 à 5 sont répétées 1 000 fois, chaque nouvel échantillon aléatoire stratifié fournissant une mutation différente de l'ensemble de modélisation initial.

Étape 7 : Calculer l'IC au moyen de la méthode des centiles

Une fois que les 1 000 prédictions ont été sauvegardées, le résultat final est créé comme suit :

  • Lancer les 1 000 répétitions.
  • Sauvegarder les valeurs des 2,5 et 97,5 centiles (25e et 975e plus grandes répétitions).

Étape 8 : Répéter les étapes 1 à 7 pour chaque culture

Toutes les étapes précédentes doivent être répétées pour chaque culture.

On peut établir un intervalle de confiance à l'aide de 1 000 répétitions bootstrap. On utilise de nouveau la méthode des centiles et supprime les 25 répétitions bootstrap les plus basses et les 25 répétitions bootstrap les plus élevées, ce qui nous donne l'intervalle de confiance à 95 %.

Le domaine spécialisé peut utiliser ces intervalles dans le cadre de son processus de validation et pendant le processus d'offre et utilisation.

6.2 Coefficient de variation robuste (CV)

Conformément à notre approche fondée sur les intervalles de confiance, on utilise une mesure robuste de la variabilité afin de réduire l'influence des estimations extrêmes issues de la méthode bootstrap, lesquelles pourraient gonfler de manière disproportionnée la variabilité estimative pour les combinaisons province-culture dont la taille de l'échantillon est réduite. Le coefficient de variation (CV) robuste pour chaque combinaison province-culture est défini comme suit :

CV robuste = MAD(estimations bootstrap) * 1 Φ -1 (0.75) prédiction

où  MAD() désigne l'écart absolu médian des estimations bootstrap par rapport à leur médiane,  Φ -1 (0.75) correspond au troisième quartile de la distribution normale standard, et  prédiction représente l'estimation obtenue à partir de la régression robuste. Le produit figurant au numérateur fournit un estimateur convergent de l'écart-type, en fonction de l'hypothèse d'une distribution bootstrap approximativement normale. En divisant cette quantité par l'estimation prédite, on obtient un coefficient de variation fiable.

7. Critères de diffusion

Un ensemble de règles fondées sur les coefficients de variation robustes pour chaque combinaison province-culture a été établi afin de déterminer quels stocks de fermeture modélisés présentent un niveau de qualité acceptable en vue de la publication. Selon ces règles, les estimations non conformes aux normes de qualité peuvent ne pas être diffusées.

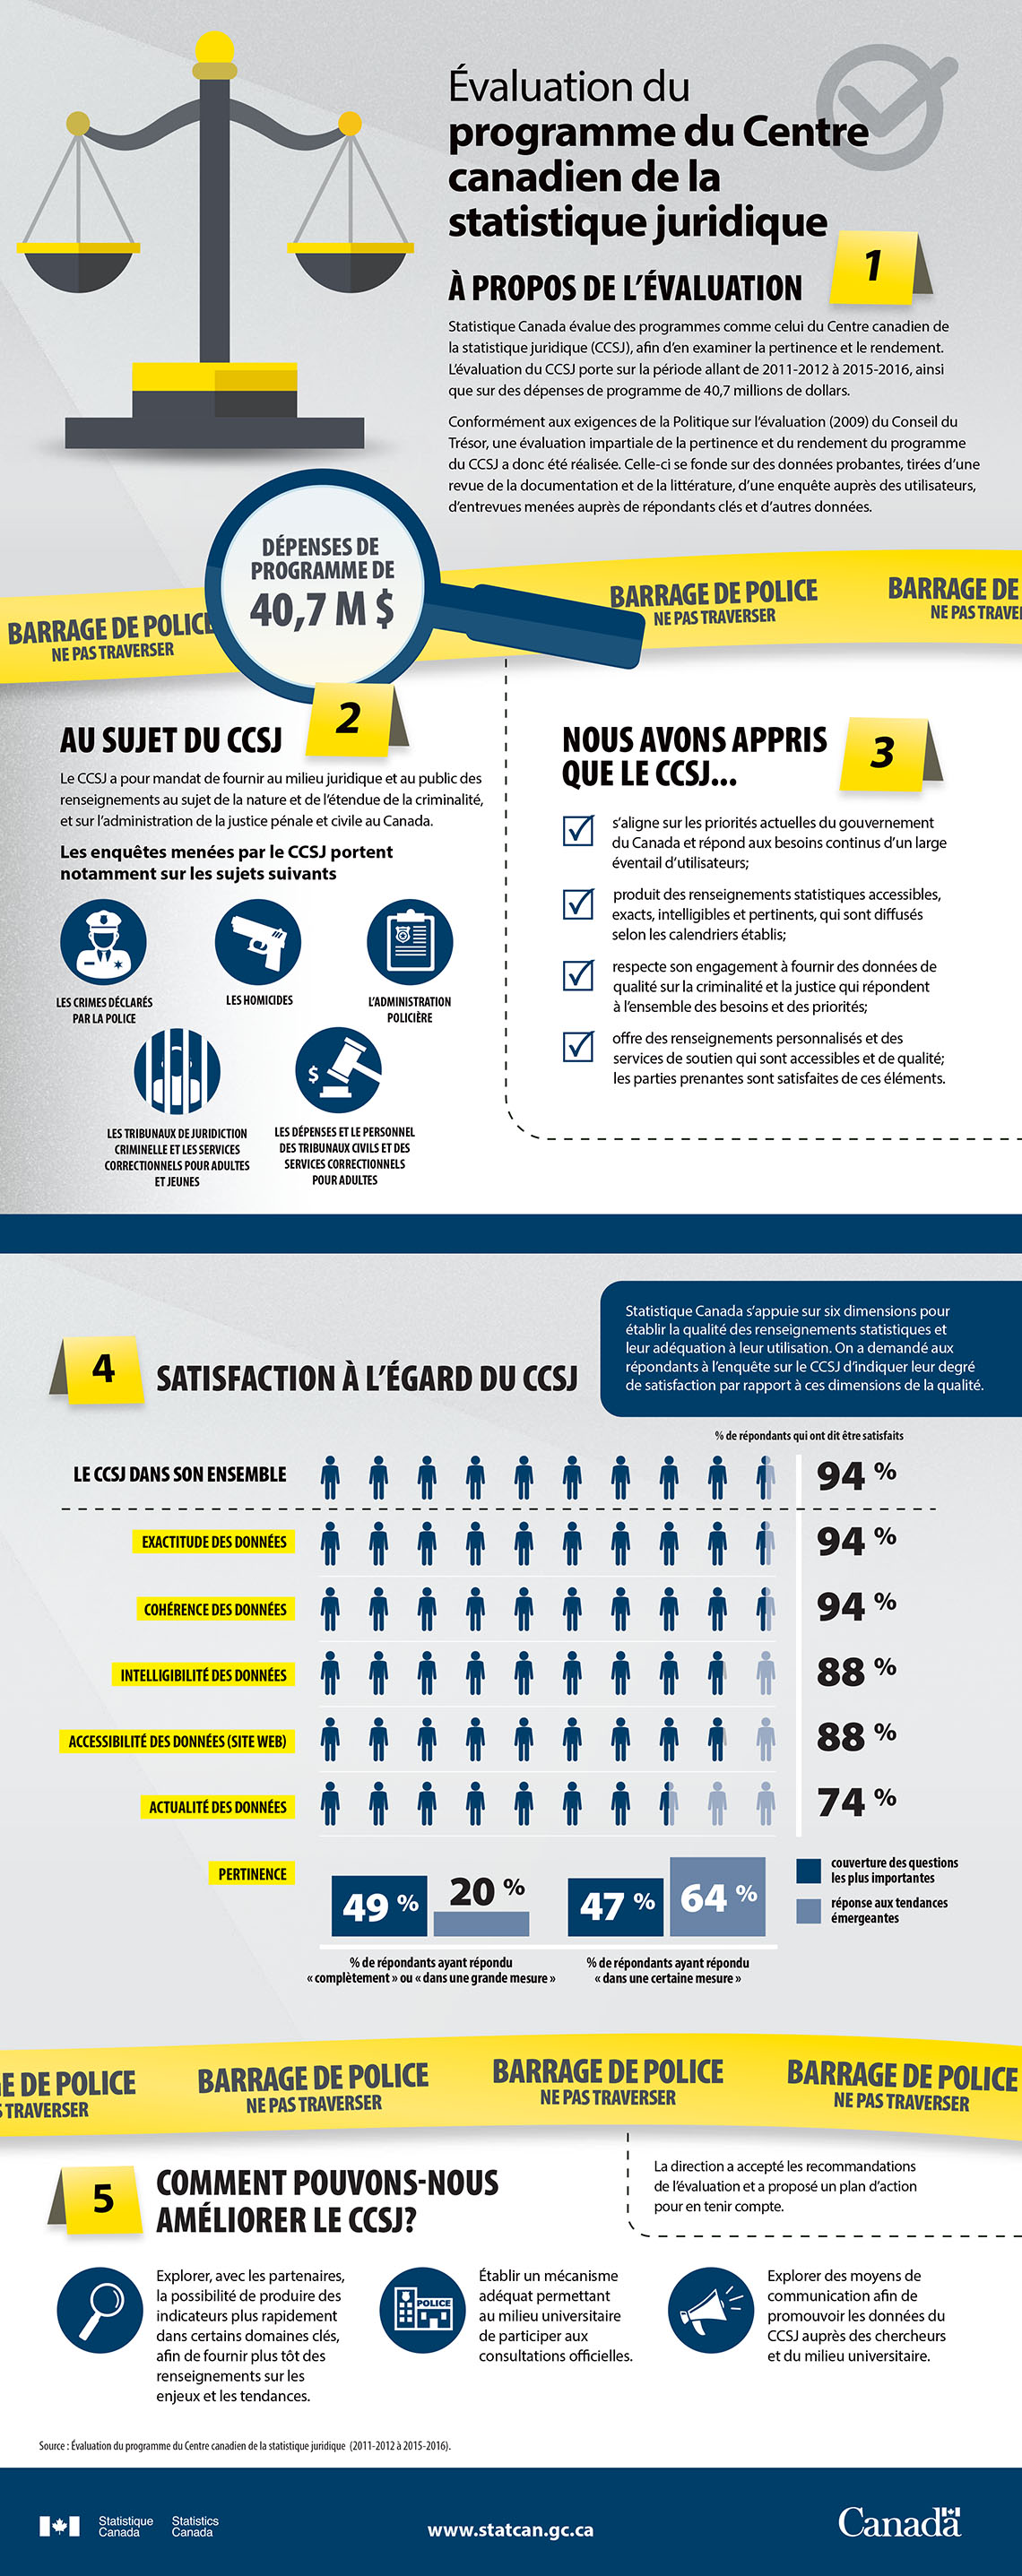
Archivé - Évaluation du programme du Centre canadien de la statistique juridique - Fiche d'information

Évaluation du programme du Centre canadien de la statistique juridique - Fiche d'information
Description - Évaluation du programme du Centre canadien de la statistique juridique - Fiche d'information

1 : À propos de l'évaluation

Statistique Canada évalue des programmes comme celui du Centre canadien de la statistique juridique (CCSJ), afin d'en examiner la pertinence et le rendement. L'évaluation du CCSJ porte sur la période allant de 2011-2012 à 2015-2016, ainsi que sur des dépenses de programme de 40,7 millions de dollars.

Conformément aux exigences de la Politique sur l'évaluation (2009) du Conseil du Trésor, une évaluation impartiale de la pertinence et du rendement du programme du CCSJ a donc été réalisée. Celle-ci se fonde sur des données probantes, tirées d'une revue de la documentation et de la littérature, d'une enquête auprès des utilisateurs, d'entrevues menées auprès de répondants clés et d'autres données.

Un ruban jaune traverse la page avec le texte : « Barrage de police Ne pas traverser ».

Une loupe apparait sur le ruban jaune avec le texte : « Dépenses de programme de 40,7 M $ »

2 : Au sujet du CCSJ

Le CCSJ a pour mandat de fournir au milieu juridique et au public des renseignements au sujet de la nature et de l'étendue de la criminalité, et sur l'administration de la justice pénale et civile au Canada.

Les enquêtes menées par le CCSJ portent notamment sur les sujets suivants :

  • les crimes déclarés par la police;
  • les homicides;
  • l'administration policière;
  • les tribunaux de juridiction criminelle et les services correctionnels pour adultes et jeunes;
  • les dépenses et le personnel des tribunaux civils et des services correctionnels pour adultes.

3 : Nous avons appris que le CCSJ...

  • S'aligne sur les priorités actuelles du gouvernement du Canada et répond aux besoins continus d'un large éventail d'utilisateurs.
  • Produit des renseignements statistiques accessibles, exacts, intelligibles et pertinents, qui sont diffusés selon les calendriers établis.
  • Respecte son engagement à fournir des données de qualité sur la criminalité et la justice qui répondent à l'ensemble des besoins et des priorités.
  • Offre des renseignements personnalisés et des services de soutien qui sont accessibles et de qualité; les parties prenantes sont satisfaites de ces éléments.

4 : Satisfaction à l'égard du CCSJ

Statistique Canada s'appuie sur six dimensions pour établir la qualité des renseignements statistiques et leur adéquation à leur utilisation. On a demandé aux répondants à l'enquête sur le CCSJ d'indiquer leur degré de satisfaction par rapport à ces dimensions de la qualité.

  • Le CCSJ dans son ensemble : 94 % de répondants qui ont dit être satisfaits
  • Exactitude des données : 94 % de répondants qui ont dit être satisfaits
  • Cohérence des données : 94 % de répondants qui ont dit être satisfaits
  • Intelligibilité des données : 88 % de répondants qui ont dit être satisfaits
  • Accessibilité des données (site Web) : 88 % de répondants qui ont dit être satisfaits
  • Actualité des données : 74 % de répondants qui ont dit être satisfaits
  • Pertinence - couverture des questions les plus importantes : 49 % de répondants ayant répondu « complètement » ou « dans une grande mesure » et 47 % de répondants ayant répondu « dans une certaine mesure »
  • Pertinence - réponse aux tendances émergentes: 20 % de répondants ayant répondu « complètement » ou « dans une grande mesure » et 64 % de répondants ayant répondu « dans une certaine mesure »

Un ruban jaune traverse la page avec le texte : « Barrage de police Ne pas traverser ».

5 : Comment pouvons-nous améliorer le CCSJ?

  • Explorer, avec les partenaires, la possibilité de produire des indicateurs plus rapidement dans certains domaines clés, afin de fournir plus tôt des renseignements sur les enjeux et les tendances.
  • Établir un mécanisme adéquat permettant au milieu universitaire de participer aux consultations officielles.
  • Explorer des moyens de communication afin de promouvoir les données du CCSJ auprès des chercheurs et du milieu universitaire.

La direction a accepté les recommandations de l'évaluation et a proposé un plan d'action pour en tenir compte.

Source : Évaluation du programme du Centre canadien de la statistique juridique (2011-2012 à 2015-2016).

Les intervalles de confiance, partie 3 : facteurs qui influencent la largeur d'un intervalle de confiance

Numéro de catalogue : 892000062026004

Date de diffusion : le 7 octobre 2026

Cette vidéo explore les trois principaux facteurs qui influencent la largeur d'un intervalle de confiance : le niveau de confiance, la variabilité au sein de la population et la taille de l'échantillon. À l'aide d'exemples concrets, les spectateurs apprendront comment ces facteurs influencent la précision des estimations d'enquête et approfondiront leur compréhension de la façon dont les intervalles de confiance permettent de communiquer l'incertitude statistique.

Étape du parcours des données

Analyser – Modéliser

Compétence des données

  • Analyse des données
  • Évaluation des décisions basée sur des donnés
  • Prise de décision basée sur des preuves

Audience

Intermédiaire

Conditions préalables suggérées

Les intervalles de confiance, partie 2 : comparer deux groupes

Durée

6:08

Coût

Gratuit

Voir la vidéo

Les intervalles de confiance, partie 3 : facteurs qui influencent la largeur d'un intervalle de confiance - Transcription

Bienvenue de nouveau dans notre série consacrée aux intervalles de confiance. Dans les première et deuxième parties, nous avons étudié les estimations ponctuelles, les marges d'erreur, les niveaux de confiance, ainsi que la comparaison de groupes à l'aide d'intervalles de confiance.

Dans cette dernière vidéo, nous nous penchons sur une question centrale : qu'est-ce qui détermine la largeur d'un intervalle de confiance?

Trois éléments influencent la largeur d'un intervalle de confiance : le niveau de confiance; la variabilité au sein de la population; la taille de l'échantillon.

Comprendre ces facteurs permet d'interpréter les estimations avec plus de précision et de communiquer l'incertitude avec davantage d'assurance.

Commençons par le niveau de confiance. Le niveau de confiance nous indique à quelle fréquence l'intervalle construit à partir de la méthode permettrait de saisir la valeur réelle si le processus d'échantillonnage était répété plusieurs fois.

Un niveau de confiance de 95 % signifie que si nous répétions la même étude plusieurs fois, environ 95 de ces intervalles sur 100 incluraient la valeur réelle. Un niveau de confiance de 99 % nous rend encore plus certains, mais l'intervalle devient plus large.

Si nous voulions un niveau de confiance de 100 %, nous pourrions élargir l'intervalle autant que possible, par exemple de 0 à 1 pour une proportion. Un tel intervalle est cependant inutile puisque nous savons déjà, sans analyser aucune donnée, que la proportion réelle doit logiquement se situer entre 0 et 1.

Toutes choses étant égales par ailleurs, un niveau de confiance plus élevé conduit à un intervalle plus large.

Pourquoi? Parce que pour être plus certains que l'intervalle contient la valeur réelle, nous devons lui permettre d'inclure une gamme plus étendue de valeurs plausibles.

Lorsque vous voyez un intervalle de confiance à 95 % et un à 99 % autour de la même estimation, remarquez que l'intervalle à 99 % s'étend davantage dans les deux sens. C'est normal : plus le niveau de confiance est élevé, plus l'intervalle est large.

Le deuxième facteur est la variabilité au sein de la population. La variabilité correspond aux différences observées entre les membres d'une population pour la caractéristique mesurée. Toutes choses étant égales par ailleurs, lorsque les individus se ressemblent beaucoup, un échantillon de petite taille peut suffire à produire une estimation précise. En revanche, lorsque les différences entre les personnes sont importantes, un plus grand volume de données est nécessaire. Cela permet d'obtenir un portrait d'ensemble plus juste et plus fiable.

Si la caractéristique mesurée est très variable, les estimations provenant de différents échantillons varieront également davantage. Cette variabilité accrue entraîne des marges d'erreur plus grandes et des intervalles de confiance plus larges.

Prenons l'exemple de deux classes de mathématiques qui sont soumises au même test : une classe de mathématiques régulière et une classe de mathématiques enrichie.

Les notes des élèves de la classe régulière varient grandement, allant d'environ 55% à plus de 85%. Lorsque vous représentez ces notes sur un graphique, le tracé s'étend sur une large fourchette. Cet écart important se traduit par une grande variabilité.

Dans la classe enrichie, la majorité des élèves obtient des notes concentrées dans une plage relativement étroite, située entre environ 85% à 95%. Cette concentration des résultats reflète une faible variabilité des notes.

Souvent, dans la pratique, la répartition de la caractéristique au sein de la population n'est pas totalement inconnue. Par exemple, avant la collecte des données, nous pouvons avoir des indices solides indiquant que cette caractéristique n'est pas répartie de manière uniforme entre les genres ou les groupes d'âge. Cela permet de concevoir une enquête de manière à accroître l'exactitude, comme nous le verrons ci-dessous lorsque nous aborderons le troisième facteur, la taille de l'échantillon.

Le troisième facteur est la taille de l'échantillon. Des échantillons plus grands réduisent l'incertitude.

Plus il y a d'observations, plus l'estimation devient précise, plus les marges d'erreur diminuent et plus les intervalles de confiance se rétrécissent.

Par exemple, supposons qu'une classe compte 100 élèves. Un échantillon de 10 élèves pourrait donner une moyenne très éloignée de la moyenne réelle de la classe. Un échantillon de 50 élèves donnera généralement un résultat beaucoup plus proche de la valeur réelle.

Une approche extrême consisterait à échantillonner tous les élèves sauf un. Cet échantillon d'une taille de 99 élèves produira une estimation très proche de la valeur réelle, puisque l'estimation et la valeur réelle sont calculées à partir des mêmes valeurs, sauf une.

Cette précision accrue se traduit directement par un intervalle plus étroit.

Ces trois éléments — le niveau de confiance, la variabilité au sein de la population et la taille de l'échantillon— agissent ensemble pour déterminer la largeur de chaque intervalle de confiance que vous rencontrez.

Gardez donc en tête que…

  • plus le niveau de confiance est élevé, plus l'intervalle est large;
  • plus la variabilité est grande, plus l'intervalle est large;
  • plus la taille de l'échantillon est petite, plus l'intervalle est large.

Lorsque vous interprétez des estimations issues d'une enquête ou que vous comparez des groupes, gardez ces facteurs à l'esprit.

Ils expliquent pourquoi certains intervalles de confiance sont étroits tandis que d'autres sont plus larges, et éclairent le degré de certitude que l'on peut raisonnablement attribuer aux résultats.

Tout au long de cette série, nous avons vu comment les intervalles de confiance nous aident à exprimer ce que nous savons (et ce que nous ne savons pas) au sujet d'une population.

Maintenant que vous comprenez l'estimation elle-même, l'incertitude qui l'entoure et les facteurs qui influencent cette incertitude, vous êtes en mesure d'interpréter les résultats d'enquête de manière plus rigoureuse et de communiquer vos conclusions avec une plus grande confiance.

(Le mot-symbole « Canada » s'affiche.)

Les intervalles de confiance, partie 2 : comparer deux groupes

Numéro de catalogue : 892000062026003

Date de diffusion : le 7 octobre 2026

Cette vidéo explique comment utiliser les intervalles de confiance pour comparer des groupes et déterminer si les différences observées sont statistiquement significatives. À l'aide d’un exemple sur les niveaux d'activité physique des hommes et des femmes selon l'âge, les spectateurs apprendront à utiliser le chevauchement des intervalles de confiance comme outil visuel simple pour interpréter les écarts et éviter de tirer des conclusions non fondées.

Étape du parcours des données

Analyser – Modéliser

Compétence des données

  • Analyse des données
  • Évaluation des décisions basée sur des donnés
  • Prise de décision basée sur des preuves

Audience

Intermédiaire

Conditions préalables suggérées

Les intervalles de confiance, partie 1 : l'incertitude liée à l'estimation

Durée

6:08

Coût

Gratuit

Voir la vidéo

Les intervalles de confiance, partie 2 : comparer deux groupes - Transcription

Bienvenue à nouveau dans notre série consacrée aux intervalles de confiance.

Dans la première partie, nous avons exploré une seule estimation et son intervalle de confiance.

Dans cette vidéo, nous allons comparer deux groupes à l'aide de leurs intervalles de confiance et découvrir une méthode visuelle rapide pour éviter de tirer des conclusions trop hâtives.

La question centrale que nous allons explorer aujourd'hui est la suivante : « Les hommes et les femmes sont-ils également susceptibles de respecter la recommandation de faire 150 minutes d'activité physique par semaine? »

Nous commencerons par examiner les estimations, puis nous intégrerons leurs intervalles de confiance afin d'interpréter les différences de manière éclairée.

Supposons que nous avons des données pour les hommes et les femmes répartis en quatre groupes d'âge : de 18 à 34 ans, 35 à 49 ans, 50 à 64 ans et 65 à 80 ans.

Les estimations indiquent que 52 % des hommes âgés de 35 à 49 ans respectent la recommandation de 150 minutes d'activité physique par semaine, contre 36 % des femmes du même groupe d'âge.

À première vue, on pourrait conclure que les hommes de ce groupe d'âge sont relativement plus actifs.

Toutefois, avant de tirer une telle conclusion, nous devons tenir compte de l'incertitude.

C'est ce que nous ferons en examinant les intervalles de confiance.

Dans la première partie de cette série, nous avons vu que les intervalles de confiance encadrent une estimation avec une plage de valeurs plausibles, reflétant l'incertitude liée à l'échantillonnage.

Plus l'intervalle est étroit, plus la précision est grande; à l'inverse, un intervalle plus large indique davantage d'incertitude.

Aujourd'hui, nous allons utiliser les intervalles de confiance pour vérifier si un nombre relativement plus élevé d'hommes sont actifs comparativement aux femmes, en appliquant une méthode simple : la vérification visuelle du chevauchement des intervalles.

Cette approche est rapide, pratique et prudente lorsqu'on ne dispose que des intervalles publiés et non du fichier analytique.

Voici le principe.

Si les intervalles de confiance ne se chevauchent pas, on peut conclure à une différence statistiquement significative.

Toutefois, s'ils se chevauchent, même légèrement, la vérification visuelle n'est pas concluante.

Dans ce cas, un test formel de la différence serait nécessaire pour confirmer si la différence est significative, mais cela exige l'accès au fichier analytique et à un logiciel adapté aux données d'enquête.

Nous n'aborderons pas la manière de procéder dans cette vidéo.

À partir de ce que nous savons maintenant sur la vérification visuelle du chevauchement, ajoutons les intervalles de confiance à notre graphique.

Pour les hommes âgés de 35 à 49 ans, l'estimation de 52 % est accompagnée d'un intervalle allant de 47 % à 57 %. Pour les femmes du même groupe, l'estimation de 36 % s'accompagne d'un intervalle allant de 32 % à 40 %. Comme ces intervalles ne se chevauchent pas, nous pouvons conclure, à partir des données, que la proportion réelle diffère selon le genre dans ce groupe d'âge.

Examinons maintenant un autre groupe d'âge : les hommes et les femmes âgés de 50 à 64 ans.

Dans ce cas, on estime que 40 % des hommes respectent les 150 minutes d'activité physique recommandées par semaine, contre 35 % des femmes.

Lorsque nous regardons de plus près, les intervalles de confiance se chevauchent.

La vérification visuelle n'est donc pas concluante : il faut éviter les affirmations catégoriques basées uniquement sur cette méthode.

Un test statistique formel, fondé sur les données sous-jacentes, pourrait révéler une différence statistiquement significative entre les hommes et les femmes de ce groupe d'âge, mais cela ne peut être déduit de la visualisation seule.

Lorsque nous ajoutons les intervalles de confiance à chaque groupe d'âge et que nous vérifions visuellement les chevauchements, nous pouvons résumer nos observations ainsi: Pour les groupes de 18 à 34 ans et de 35 à 49 ans, un nombre relativement plus élevé d'hommes respecte la recommandation hebdomadaire d'activité physique comparativement aux femmes.

En revanche, pour les hommes et les femmes de 50 à 64 ans et de 65 à 80 ans, la vérification visuelle n'est pas concluante.

Cela signifie que nous devons éviter de tirer des conclusions uniquement à partir du graphique.

Chaque fois que nous communiquons des conclusions clés, il est important que notre formulation reflète fidèlement ce que le graphique ou le tableau peut réellement nous apprendre.

Dans l'exemple d'aujourd'hui, nous avons vu que lorsque les intervalles de confiance ne se chevauchent pas, on peut raisonnablement conclure à une différence statistiquement significative entre les hommes et les femmes pour les groupes d'âge concernés.

En revanche, lorsque les intervalles se chevauchent, la vérification visuelle n'est pas concluante; un test formel serait nécessaire pour évaluer la différence.

Cette approche garantit que notre message reste clair et mesuré, sans en exagérer la portée.

Dans la troisième et dernière partie de notre série, nous verrons quels facteurs influencent la largeur d'un intervalle de confiance.

(Le mot-symbole « Canada » s'affiche.)